Agents IA en entreprise : workflows qui tiennent en prod
Un agent utile en production combine outils métier, garde-fous et supervision. Un bon prompt ne suffit plus.
Du chatbot à l'agent opérable
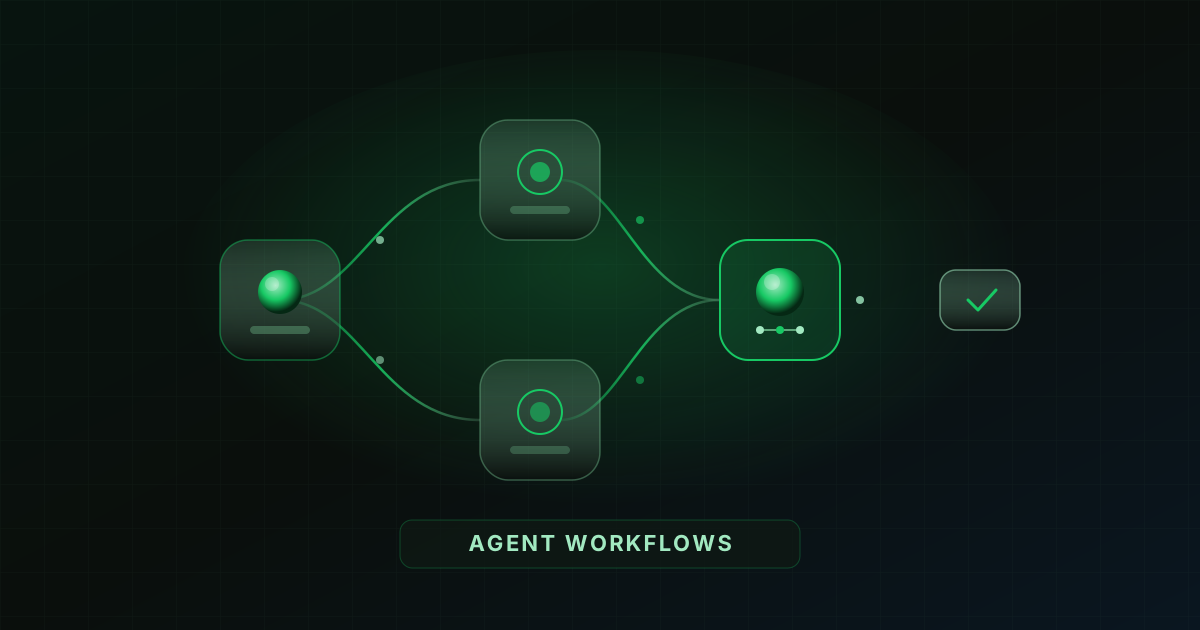
Un chatbot répond. Un agent agit : il appelle des APIs, enchaîne des étapes, demande une validation humaine quand le risque monte, et laisse une trace que le support peut relire. En entreprise, cette différence décide du passage en production. Les métiers ne veulent plus une boîte de dialogue décorative. Ils veulent un workflow qui crée le bon ticket, retrouve la bonne procédure, met à jour le bon champ, et s'arrête proprement quand les droits ou les données manquent.
Les agents enterprise doivent donc appeler des outils avec des périmètres, respecter des quotas, et échouer de façon explicite. Un timeout ERP ou un refus IAM n'est pas une « hallucination » : c'est un signal opérationnel. Si la plateforme ne le remonte pas dans une timeline claire, l'agent reste un POC, brillant en démo, opaque dès le premier incident du vendredi soir.
Le passage à l'échelle ajoute une autre contrainte : plusieurs équipes, plusieurs catalogues d'outils, plusieurs niveaux de criticité. Sans gouvernance commune, chaque projet réinvente ses garde-fous, et la DSI retrouve exactement la fragmentation qu'elle cherchait à éviter.
Orchestration : plan, outils, politiques
L'architecture qui tient sépare trois boucles, versionnables indépendamment :
- Planification: l'agent décompose la demande (rechercher, comparer, agir, vérifier). Le plan doit être inspectable : on veut savoir ce que l'agent comptait faire avant qu'il le fasse.
- Exécution d'outils: chaque action (chercher doc, créer ticket, lire fiche client, poster un commentaire) est un connecteur scoped, avec schéma d'entrée/sortie et owner métier.
- Politiques: quotas tokens, listes d'outils autorisés par rôle, seuils d'approbation, refus sur actions hors catalogue.
Sans cette séparation, on obtient un mega-prompt fragile : tout est dans le contexte, rien n'est auditable, et le moindre changement métier (nouveau champ ERP, nouvelle politique RH) casse le comportement de façon invisible. Avec elle, on peut tester les politiques unitairement, publier un outil derrière une revue IAM, et rejouer un incident étape par étape, plus proche de l'esprit de la boucle ReAct (raisonner → agir → observer) que d'une complétion opaque unique.
Les connecteurs doivent réutiliser l'identité de l'utilisateur (délégation / OBO) plutôt qu'un compte de service omnipotent. Sinon l'agent devient un raccourci pour contourner l'IAM, exactement ce que la DSI et la conformité refusent. Quand un outil écrit dans un système critique, exigez aussi l'idempotence ou un correlateur : les retries ne doivent pas créer trois tickets pour la même demande.
Outils avec périmètre
Chaque action (créer ticket, chercher doc) est limitée par le rôle de l'utilisateur, comme dans vos apps existantes.
Modes d'autonomie et points de contrôle
Tous les cas d'usage n'exigent pas le même niveau d'autonomie. Forcer l'autonome partout produit des incidents ; tout garder en assisté produit de la friction et un abandon métier. Trois modes couvrent l'essentiel :
- Chat assisté: l'agent propose un plan et des actions ; l'humain valide chaque étape sensible. Idéal pour les débuts de parcours et les domaines réglementés.
- Semi-autonome: enchaînement libre sur la recherche, la synthèse et les lectures ; validation humaine avant toute écriture (ticket, mail externe, mise à jour ERP).
- Autonome borné: actions à faible risque dans un catalogue fermé (ouvrir un ticket de niveau 1 avec un template, classer une demande, enrichir une fiche avec des champs non critiques).
Les workflows longs nécessitent des checkpoints explicites : plan → action → vérification. Définissez ce qui est irréversible (paiement, suppression, envoi hors périmètre, modification de droits) et forcez l'approbation avec un responsable identifiable. Documentez le rollback : annuler un ticket créé, restaurer un statut, notifier le demandeur, compenser une écriture partielle.
Le choix du mode n'est pas figé pour toujours : un cas d'usage peut démarrer en assisté, puis passer en semi-autonome une fois les outils stables et le taux d'erreur sous contrôle. Mesurez ce taux, pas seulement la satisfaction conversationnelle.
Niveaux d'autonomie
Chat, assisté ou autonome : AI for leaders adapte le niveau d'autonomie selon le cas d'usage et la criticité.
« L'agent n'est pas magique, c'est un orchestrateur avec des règles. »
Ce qui casse en production (et comment s'en prémunir)
Les modes de panne récurrents, observés dès les premiers mois :
- Boucles d'outils: l'agent rappelle la même API faute de progrès ; imposez des plafonds d'appels par session, un circuit breaker, et un message d'échec explicite.
- Contexte saturé: trop de chunks RAG + historique long ; tronquez avec priorité aux citations, au plan courant et à la dernière action, pas à un dump chronologique.
- Dérive de droits: outil ajouté « vite fait » sans revue IAM ni owner ; exigez une checklist de publication (périmètre, données touchées, logs, rollback).
- Silence opaque: modèle ou outil down ; affichez un mode dégradé clair au lieu d'une réponse inventée ou d'un spinner infini.
- Succès trompeur: l'outil répond 200 mais avec un payload partiel ; validez les invariants métier après l'appel (ticket créé avec le bon service, pièce jointe présente, etc.).
Le support N2 a besoin d'une timeline : entrée utilisateur, plan, appels d'outils (statut, latence, correlateur), politiques déclenchées, sorties, validations humaines. Sans ça, chaque incident redevient une séance de prompt engineering, coûteuse et non transférable.
Gouvernance et critères de choix
Évaluez une plateforme agents sur des preuves, idéalement sur un pilote dans votre SI, avec un cadre de gouvernance comme le NIST AI RMF :
- Propagation IAM jusqu'aux outils et au retrieval, avec tests de non-régression sur des profils contrastés.
- Catalogue d'outils versionné, avec owners métier et historique de publication.
- Budgets et quotas par équipe / cas d'usage, visibles pour la DSI.
- Export d'audit pour conformité, homologation et post-mortem.
- Déploiement dans votre périmètre (on-prem / cloud souverain), pas seulement un SaaS opaque.
- Stratégie de fallback modèle et comportement sous charge (files, priorités, rejet propre).
- Contrats propres pour exposer des automations existantes comme outils (événements, APIs, éventuellement MCP).
AI for leaders se positionne ici : couche agentique avec gouvernance intégrée, RAG et passerelle modèles dans le même socle, face aux copilots génériques qui excellent en chat mais sous-investissent l'opérabilité, l'audit et le contrôle de périmètre.
Une séquence de pilote utile : démarrer en assisté lecture seule sur un process à forte valeur (Q&A procédures + brouillon de ticket), mesurer pendant deux semaines la qualité des citations et le taux d'erreur d'outils, puis débloquer une seule écriture derrière validation humaine. Ce n'est qu'après que le N2 peut diagnostiquer les échecs depuis les logs qu'il faut élargir le catalogue d'outils ou relever l'autonomie, mieux qu'un lancement « agent autonome pour tout ».
Conclusion
Les agents d'entreprise gagnent quand ils s'intègrent au SI existant avec une gouvernance dans la même plateforme : outils à périmètre limité, modes d'autonomie explicites, audit rejouable, échecs lisibles. Le prompt reste nécessaire. Il ne suffit plus à passer en production.
Pour le contraste avec l'automatisation déterministe, voir n8n vs AI for leaders ; pour ancrer les réponses dans vos sources, les patterns RAG enterprise.
À lire ensuite
Pourquoi l'IA souveraine compte en entreprise
Le chatbot ne suffit plus. Il faut une plateforme où les données restent sous contrôle.
Par Florian Gabon · 6 août 2026
RAG enterprise : 3 patterns qui tiennent en prod
Un POC RAG réussit en démo ; en production, c'est la gouvernance des sources qui fait la différence.
Par Florian Gabon · 30 juillet 2026
Données et IA : le périmètre souverain
Résidence, chiffrement, journaux d'audit : trois leviers pour une IA d'entreprise crédible.
Par Florian Gabon · 23 juillet 2026