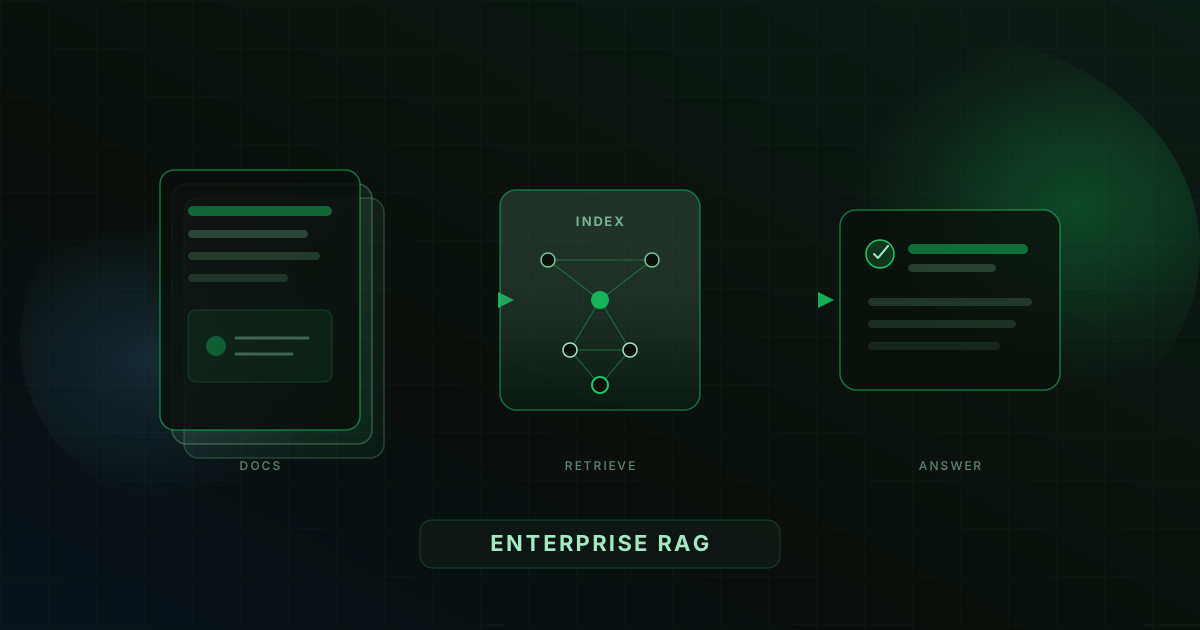
RAG enterprise : 3 patterns qui tiennent en prod
Un POC RAG réussit en démo ; en production, c'est la gouvernance des sources qui fait la différence.
Au-delà du « dump PDF dans un bucket »
Un POC RAG impressionne : on indexe un dossier, on pose trois questions, le modèle répond avec assurance. En production, le même pipeline casse dès qu'apparaissent des droits hétérogènes, des documents obsolètes, des formats métier (tableaux, procédures multi-pages) et des équipes qui exigent de vérifier la source avant d'agir. Le RAG d'entreprise n'est pas un script d'embedding. C'est un produit de gouvernance des connaissances, bien au-delà du setup de démo du papier RAG d'origine.
Sans périmètres par équipe, sources versionnées et citations vérifiables, les hallucinations deviennent un risque opérationnel : une procédure RH inventée, une clause contrat mal attribuée, une réponse « plausible » ancrée dans un document que l'utilisateur n'avait pas le droit de voir. Le coût n'est pas seulement réputationnel, c'est du temps N2, des décisions métier faussées, et un arrêt projet au premier incident sérieux.
Les trois patterns ci-dessous sont ceux que l'on retrouve chez les organisations qui passent réellement le cap des premiers milliers d'utilisateurs.
Pattern 1: Sources par périmètre IAM
Chaque connecteur (GED, SharePoint, ERP, wiki interne) doit exposer un périmètre d'accès aligné avec l'IAM existant. L'agent ne voit que ce que l'utilisateur peut déjà consulter. Concrètement : le filtre de retrieval applique groupes et ACL avant le ranking sémantique, pas après une génération « et on masque si besoin ». Filtrer trop tard, c'est déjà avoir injecté le contenu sensible dans le contexte du modèle.
Les échecs classiques en prod :
- Indexer « tout le drive » avec un compte de service, puis filtrer trop tard → fuite latente dans le prompt.
- Dupliquer des droits dans un second système de tags → dérive dès la première mutation RH ou le premier partage externe.
- Mélanger espaces publics et confidentiels dans le même index sans namespace → pollution du retrieval et fausses confidences.
- Oublier les documents « cassés » (ACL orphelines, liens morts) qui restent dans l'index des mois après leur retrait métier.
Le pattern robuste : namespaces ou collections par domaine, métadonnées de sensibilité, sync périodique des ACL depuis la source de vérité, et tests de non-régression sur un jeu d'utilisateurs aux profils contrastés. Quand un collaborateur quitte une équipe, le retrieval suit, sans rebuild manuel de l'index.
Citations obligatoires
Chaque réponse RAG doit pointer vers le document source, sinon le métier ne valide pas le déploiement.
Pattern 2: Ingestion versionnée et reranking ciblé
La qualité du retrieval dépend autant de l'ingestion que du modèle. Un chunking naïf (pages PDF découpées au hasard, titres séparés du corps) détruit les tableaux, les listes de contrôles et les en-têtes de procédure. En enterprise, on versionne les sources : date de publication, propriétaire, statut (brouillon / publié / archivé), et on retire les versions obsolètes de l'index au lieu de les laisser concurrencer les chunks à jour.
Après le retrieval dense, ou hybride BM25 + vecteur, souvent plus robuste sur les acronymes métier, un reranker léger réduit le bruit sans exploser la latence. C'est fréquemment le levier le plus rentable avant de changer de modèle : moins de contexte inutile, moins d'hallucinations « collées » à un mauvais extrait, coûts tokens mieux maîtrisés, réponses plus courtes et plus actionnables. Pour la baseline lexicale derrière le search hybride, voir BM25.
Points de contrôle opérationnels à contractualiser avec le métier :
- Alertes si le taux de réponses sans citation exploitable monte au-delà d'un seuil.
- Latence p95 retrieval + rerank sous un budget défini (souvent plus critique que le temps de génération pour l'UX).
- Rejeu d'un jeu de questions de référence après chaque re-ingestion majeure ou changement de chunking.
- Mesure du « stale hit » : réponses qui citent encore une version archivée.
Pattern 3: Gouvernance des réponses et boucle d'audit
Le troisième pattern est rarement dans les tutos : traiter chaque réponse comme un événement auditable. Qui a interrogé quoi, quels chunks ont été injectés (identifiants, scores), quelles citations ont été affichées, quel modèle a généré, quelles politiques ont bloqué une action. Sans ça, le support N2 ne peut ni expliquer ni corriger un incident, et la conformité ne peut pas démontrer le contrôle, l'esprit de gouvernance du NIST AI Risk Management Framework.
Ajoutez des garde-fous métier : refus explicite si aucune source n'atteint un seuil de score ; mode « citations only » pour les domaines réglementés ; escalade humaine quand la confiance est basse ou quand la question touche un sujet hors catalogue. Les feedbacks utilisateurs (utile / faux / hors périmètre / source incorrecte) doivent revenir dans le backlog d'ingestion et de curation, pas seulement dans un dashboard vanity metrics.
Côté plateforme, cela implique aussi la rétention des traces (durée, chiffrement, qui peut exporter), et des scénarios de panne : connecteur GED en timeout, index désynchronisé après une migration SharePoint, pic de charge qui allonge le rerank, modèle primaire indisponible. Prévoyez un mode dégradé (réponses plus courtes, file d'attente, message clair) plutôt qu'un silence opaque ou une invention confiante.
Gouvernance dans la même couche
Policies, journaux et périmètres dans la même couche que l'index, pas un script d'export collé après coup.
Conclusion
Le RAG d'entreprise est un produit de gouvernance des connaissances, pas un script d'embedding. Périmètre IAM, ingestion versionnée avec reranking, et audit des réponses forment le triptyque qui tient en production. Les modèles évoluent chaque trimestre ; ces patterns restent et se renforcent avec le volume.
AI for leaders positionne le RAG comme couche de plateforme : connecteurs, index, permissions et audit dans le même périmètre souverain, pour que le passage du POC à la prod ne soit pas une réécriture. Pour le cadre de résidence autour de ces index, lisez aussi notre article sur le périmètre souverain des données.
À lire ensuite
Pourquoi l'IA souveraine compte en entreprise
Le chatbot ne suffit plus. Il faut une plateforme où les données restent sous contrôle.
Par Florian Gabon · 6 août 2026
Données et IA : le périmètre souverain
Résidence, chiffrement, journaux d'audit : trois leviers pour une IA d'entreprise crédible.
Par Florian Gabon · 23 juillet 2026
Agents IA en entreprise : workflows qui tiennent en prod
Un agent utile en production combine outils métier, garde-fous et supervision. Un bon prompt ne suffit plus.
Par Florian Gabon · 16 juillet 2026