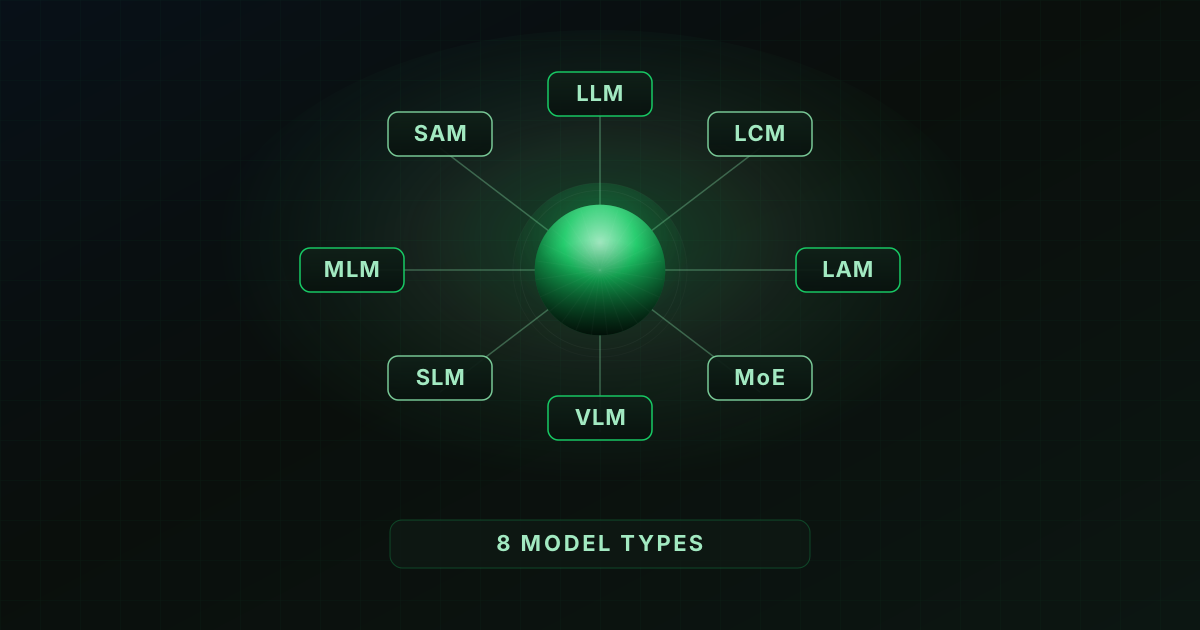
8 types de modèles IA spécialisés
LLM, LCM, LAM, MoE, VLM, SLM, MLM, SAM : quelle famille pour quelle tâche, plutôt qu'un LLM pour tout.
Un LLM ne suffit plus
En entreprise, le réflexe reste souvent le même : brancher un grand modèle de langage et lui demander de tout faire, rédiger, classer, extraire, piloter un outil, décrire une image. Ça marche en démo. En production, les coûts explosent, la latence devient imprévisible, et les échecs (vision, action, contexte long, petit déploiement) se multiplient sans diagnostic clair.
Un socle IA mature ne parle plus d'un « modèle unique ». Il parle d'un catalogue de familles spécialisées. Huit types reviennent partout dans les architectures modernes : LLM, LCM, LAM, MoE, VLM, SLM, MLM et SAM. Comprendre ce que chacun optimise, et ce qu'il ne fait pas, évite de surpayer un LLM géant pour une tâche que ferait mieux un petit modèle local, un mélange d'experts, ou un segmentateur vision.
Les 8 familles, en clair
LLM (Large Language Model): le générateur de texte et de raisonnement linguistique. Idéal pour synthèse, rédaction assistée, Q&A, planification légère. Limite : cher et généraliste ; ce n'est pas un moteur d'action ni un spécialiste vision.
LCM (Large Concept Model): travaille au-dessus des tokens, sur des concepts ou représentations plus abstraites. Utile quand le besoin est de relier des idées, des politiques ou des documents longs plutôt que de produire phrase par phrase. Encore émergent, mais pertinent pour la gouvernance de connaissances et le raisonnement multi-documents.
LAM (Large Action Model): orienté exécution : planifier puis appeler des outils, APIs, workflows. C'est la famille qui rapproche le modèle de l'agent opérable. Sans catalogue d'outils à périmètre limité et sans politiques, un LAM reste un LLM qui improvise des appels.
MoE (Mixture of Experts): architecture qui active seulement un sous-ensemble d'experts par requête. Objectif : capacité élevée à coût d'inférence maîtrisé, popularisé en production par des systèmes comme Mixtral. En entreprise, c'est souvent le bon compromis pour un hub multi-équipes, à condition de mesurer quels experts sont sollicités et sous quelle charge.
VLM (Vision-Language Model): joint image (ou document scanné) et texte. Cas d'usage concrets : OCR intelligent, lecture de plans, analyse de captures d'écran support, contrôle qualité. Ne remplace pas un segmentateur précis quand le besoin est purement spatial.
SLM (Small Language Model): modèles compacts, rapides, déployables on-prem / edge / VPC privé. Parfaits pour classification, extraction structurée, assistants locaux, pré-filtres avant un LLM coûteux. La souveraineté et le coût unitaire commencent souvent ici.
MLM (Masked Language Model): comprend le texte en prédisant des parties masquées (tradition BERT). Excellent pour ranking, similarité, classification, NER, pas pour générer de longs textes. Souvent invisible dans le socle, mais critique dans le retrieval et le scoring.
SAM (Segment Anything Model): segmentation d'objets dans l'image, quasi zero-shot, voir Segment Anything (Meta). Utile en inspection industrielle, cartographie, préparation de datasets vision. Ce n'est pas un chatbot : c'est un outil de perception à brancher dans un pipeline.
Spécialisation vs monolithe
Un LLM géant pour tout coûte cher et masque les échecs. Un catalogue de familles rend chaque échec mesurable.
Agents, RAG, vision : comment composer
En pratique, une plateforme comme AI for leaders ne « choisit pas un modèle » : elle route selon la tâche.
- Un agent support lit une capture d'écran (VLM), extrait les champs (SLM / MLM), génère une réponse (LLM), et crée un ticket (LAM + outils).
- Un RAG d'entreprise utilise un MLM / embedder pour le ranking, un LLM pour la synthèse, parfois un LCM pour relier des politiques qui couvrent plusieurs métiers.
- Un contrôle qualité usine s'appuie sur SAM + VLM, avec un SLM local pour le verdict structuré, sans exporter les images hors périmètre.
Le critère n'est pas « le plus grand modèle », mais le chemin le plus court entre signal métier et action contrôlée : latence, coût tokens, résidence des données, auditabilité.
MoE et coût maîtrisé
Activer seulement les experts utiles par requête : capacité élevée sans payer l'inférence d'un dense géant à chaque appel.
Critères de choix en entreprise
Avant d'ajouter une famille au catalogue, posez quatre questions :
- Périmètre des données: le flux peut-il rester dans votre VPC / cloud souverain ? Un SLM ou un MoE auto-hébergé change souvent la décision plus qu'un benchmark MMLU.
- Mode d'échec: que se passe-t-il si le modèle hallucine, rate une segmentation, ou refuse un outil ? Les modes dégradés doivent être définis par famille.
- Coût unitaire: coût par 1 000 requêtes en conditions réelles (contexte long, images, retries), pas le prix catalogue du provider.
- Conformité: transparence, logs, human oversight. Certaines tâches basculent vite sous le régime high-risk de l'AI Act européen (page Commission).
Le piège classique : acheter un VLM premium pour du texte pur, ou forcer un LLM à « voir » via des descriptions alors qu'un SAM + règles métier suffirait. L'inverse existe aussi, multiplier les spécialistes sans passerelle unifiée, et retrouver une jungle de clés API sans gouvernance.
Conclusion
Les huit types, LLM, LCM, LAM, MoE, VLM, SLM, MLM, SAM, ne sont pas une mode LinkedIn. C'est la grille pour déployer l'IA en production sans surpayer ni sous-sécuriser. La maturité, c'est un catalogue versionné, des politiques de routing, et des preuves (latence, coût, audit) par famille.
Pour enchaîner sur l'orchestration agents, voir les workflows agents en entreprise ; pour le cadre réglementaire du déploiement, l'AI Act européen ; pour le contrôle du périmètre, pourquoi l'IA souveraine compte.
À lire ensuite
Agents IA en entreprise : workflows qui tiennent en prod
Un agent utile en production combine outils métier, garde-fous et supervision. Un bon prompt ne suffit plus.
Par Florian Gabon · 16 juillet 2026
AI Act européen : conformité concrète pour l'entreprise
Classification, obligations, checklist. Ce que l'AI Act change vraiment une fois l'IA en production.
Par Florian Gabon · 4 août 2026
Pourquoi l'IA souveraine compte en entreprise
Le chatbot ne suffit plus. Il faut une plateforme où les données restent sous contrôle.
Par Florian Gabon · 6 août 2026